Shrnutí:
- GPT-6 Astra ukazuje výrazný posun hlavně v praktickém vykonávání úkolů, práci s počítačem a používání nástrojů.
- Největší změnou dalších generací podle mě nebude jen vyšší „inteligence“, ale schopnost spolehlivě dokončit větší část práce bez průběžného vedení.
- Očekávám další rozvoj práce více AI agentů, automatické kontroly výsledků a práce přímo ve firemních systémech.
- GPT-7 bych podle současného tempa vývoje očekával přibližně mezi druhou polovinou roku 2027 a začátkem roku 2028.
- Firmám bych doporučil méně řešit dokonalé prompty a více se soustředit na pořádek v datech, procesech a oprávněních.
OpenAI představilo GPT-6 Astra 3. září 2026. Když jsem se následně podíval do svého ChatGPT, čekalo mě trochu překvapení. GPT-6 sice existuje, ale v běžném chatu na tarifu Plus stále používám GPT-5.6 Sol. Astru mám dostupnou ve Worku a Codexu. Podle aktuální dokumentace OpenAI nejde o chybu.
Je docela dobře možné, že už za několik týdnů bude situace jiná. Původní oznámení Astry ostatně hovořilo o postupném zpřístupňování uživatelům Plus, Pro, Business a Enterprise. Berte proto následující popis jako stav v době psaní článku, ne jako něco, co bude platit navždy.
Co jsem zatím s Astrou zkoušel
Astru jsem testoval především ve Worku. První dojem mám trochu rozporuplný. Model je evidentně určený pro složitější práci, ale na tarifu Plus dokáže také poměrně rychle spotřebovávat dostupný limit. OpenAI samo upozorňuje, že spotřeba závisí na délce zadání, nástrojích, složitosti úkolu a množství přemýšlení, které model používá.
Pro současné používání mi limity nevyhovují. Astru bych si nechával na opravdu komplikované úkoly, finální kritickou kontrolu nebo situaci, ve které už GPT-5.6 Sol nestačí. Na běžný e-mail, krátkou analýzu nebo jednoduché zpracování textu nemá podle mě moc smysl spotřebovávat nejsilnější dostupný model.
Psal jsem o tom také na LinkedIn. V diskusi se mimo jiné ukázalo, že podobně to vnímá více lidí. U jednodušší práce může být rozdíl proti Solu poměrně malý, zatímco u složitých programátorských nebo agentních úloh už jsou zkušenosti výrazně lepší.
To mi vlastně dává smysl. Ani u lidí nepoužíváme nejdražšího specialistu na každou drobnost. Důležité není mít vždy nejsilnější model, ale zvolit model odpovídající problému.
Čekám ještě GPT-6 Sol a GPT-6 Luna
Současná Astra podle mě zároveň nebude posledním slovem generace GPT-6.
Dnes máme v generaci 5.6 několik modelů pro různé typy použití. Sol je určený pro náročnější práci, Luna je výrazně levnější a rychlejší a existuje také Terra jako mezistupeň. Rozdíl je dobře vidět i v cenách API. GPT-6 Astra stojí 10 dolarů za milion vstupních a 50 dolarů za milion výstupních tokenů. GPT-5.6 Sol stojí 4 a 20 dolarů, Luna pouze 0,20 a 1,20 dolaru. Astra tedy není model, který by dávalo ekonomický smysl používat úplně na všechno.
Proto očekávám, že se časem objeví také běžnější varianta generace 6 odpovídající dnešnímu Solu a levnější varianta podobná Luně. Pracovně jim říkám GPT-6 Sol a GPT-6 Luna, ale je důležité zdůraznit, že OpenAI tyto modely zatím neoznámilo a názvy jsou pouze můj odhad. Marketingově by dávalo smysl používat zavedené názvy. Firma je poprvé představila s verzí GPT 5. 6. V předchozích verzích používala pouze číselná označení.
Pokud se ale něco podobného skutečně objeví, může být právě GPT-6 Sol pro běžné uživatele zajímavější změnou než dnešní Astra. Levnější model může stejné principy nabídnout pro každodenní práci.
Benchmark není skutečná práce ve firmě
U každého nového AI modelu se objeví řada působivých výsledků různých testů. Pro člověka, který se vývojem AI nezabývá profesionálně, jsou většinou obtížně srozumitelné. Tyto testy si můžete představit jako standardizovanou zkoušku. Výsledek maturity vám něco řekne o znalostech studenta, ale neřekne vám s jistotou, zda z něj bude dobrý zaměstnanec. Podobné je to u AI.
Model může být výborný v matematickém testu a přitom pokazit jednoduchou tabulku. Může správně analyzovat odborný text a následně uvést zdroj, který ve skutečnosti neexistuje. Samotné vysoké procento proto neznamená, že bude model stejně dobře fungovat při každodenní práci. Mně připadá zajímavější sledovat, ve kterých oblastech se výsledky mezi generacemi mění nejrychleji. A u Astry je v tom poměrně jasná stopa.
Chytřejší model není totéž jako chytřejší ChatGPT
Při úvahách o GPT-7 je potřeba rozlišit jednu technickou věc, kterou běžný uživatel ChatGPT většinou vůbec nevidí. To, co vnímáme jako „AI“, už dnes není pouze jeden jazykový model.
Samotný model, například GPT-5.6 Sol nebo GPT-6 Astra, je pouze jednou částí systému. Kolem něj funguje další vrstva, pro kterou se používá označení agentic harness. Zjednodušeně jde o prostředí, které propojuje model s nástroji, soubory, internetem, dalšími agenty nebo aplikacemi a řídí průběh delší práce.
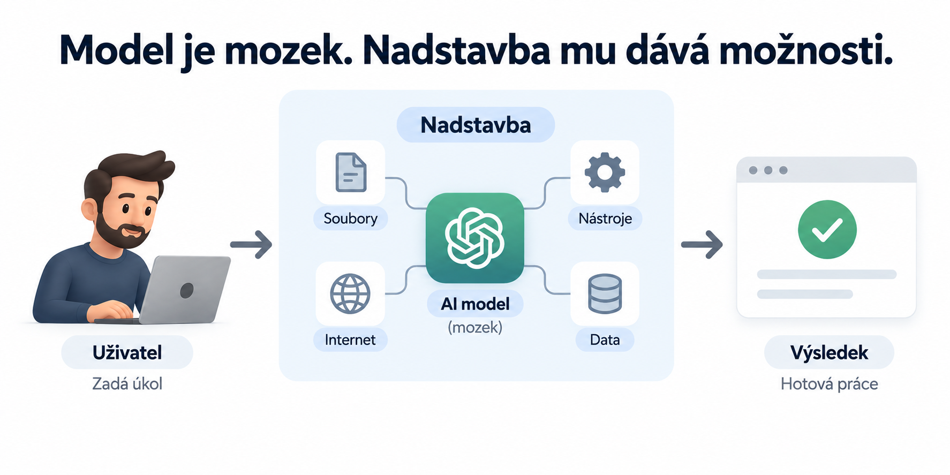
Zadám například AI, aby našla chybu na webu, opravila ji a výsledek otestovala. Samotný model může pochopit problém a rozhodovat o dalším postupu. Někdo mu ale musí zpřístupnit soubory, umožnit spustit příkazy, zobrazit web, vrátit výsledky testů a případně celý postup zopakovat. Právě to řeší systém kolem modelu.
Dalším krásným příkladem je používání ChatGPT pro matematické výpočty. Ve skupině na Facebooku věnované umělé inteligenci, se objevil příspěvek vysokoškolského studenta, který si stěžoval na špatné počítání ChatuGPT. Člen skupiny Michal Kubíček studentovi vysvětlil, aby výpočet nenechával na AI, ale rozhraní použil pro spuštění Pythonu. A tomu zadal daný matematický příklad. Jazykový model pak výsledek předloží.
Codex, ChatGPT Work nebo Claude Code podobné principy používají už dnes. Současné systémy umějí rozdělit práci mezi více agentů, používat externí nástroje, procházet soubory, spouštět programy nebo kontrolovat část vlastních výsledků.
To mění i pohled na GPT-7. Řada schopností, které bychom mu mohli intuitivně přisuzovat, nemusí vůbec vzniknout až s novým modelem. Technicky už dnes můžeme postavit systém, ve kterém jeden agent vyhledává informace, další je kontroluje, jiný provede změnu a další výsledek otestuje. Problém je především v tom, jak spolehlivě celý systém funguje.
Proč tedy ještě potřebujeme lepší modely?
Mohlo by se zdát, že pokud už máme nástroje, agenty a automatické kontroly, další zvyšování inteligence modelů není příliš důležité. Tak jednoduché to podle mě není.
Nadstavba kolem AI modelu může modelu umožnit spustit deset různých nástrojů. Model ale stále musí správně rozhodnout, který z nich použít, v jakém pořadí a co si počít s výsledkem. Může dostat možnost rozdělit práci mezi několik agentů, ale musí poznat, kdy to má smysl, jak jim práci zadat a kterým závěrům následně věřit.
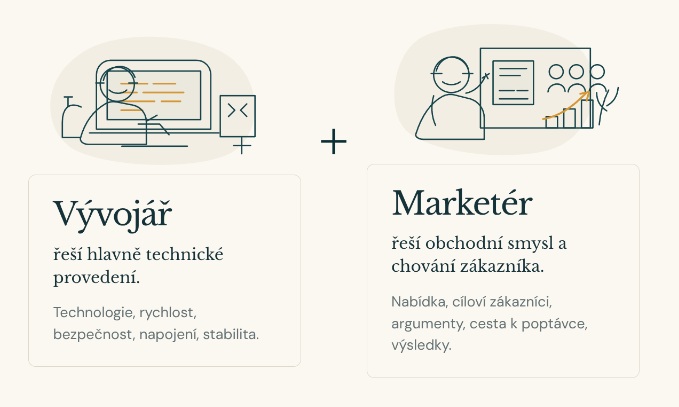
Stejně tak může systém po vytvoření programu automaticky spustit test. Pokud test selže, model ale musí pochopit proč a vymyslet správnou opravu. Výsledek proto vzniká kombinací několika věcí: schopností samotného modelu, kvality systému kolem něj, dostupných nástrojů, správného kontextu a nastavených kontrol.
Proto bych dnes svou předpověď GPT-7 formuloval trochu jinak. Neočekávám, že nový model najednou objeví všechny tyto schopnosti. Mnohé už existují. Zajímavější bude sledovat, zda je další generace modelů a systémů kolem nich dokáže používat podstatně spolehlivěji.
Rozdíl může být podobný jako mezi pracovníkem, kterému dáte přístup ke všem firemním nástrojům, a pracovníkem, který navíc dobře pozná, kdy který nástroj použít, dokáže si svou práci zkontrolovat a ví, kdy si naopak musí říct člověku o rozhodnutí. Právě tato kombinace může být důležitější než další zvýšení skóre v testech inteligence.
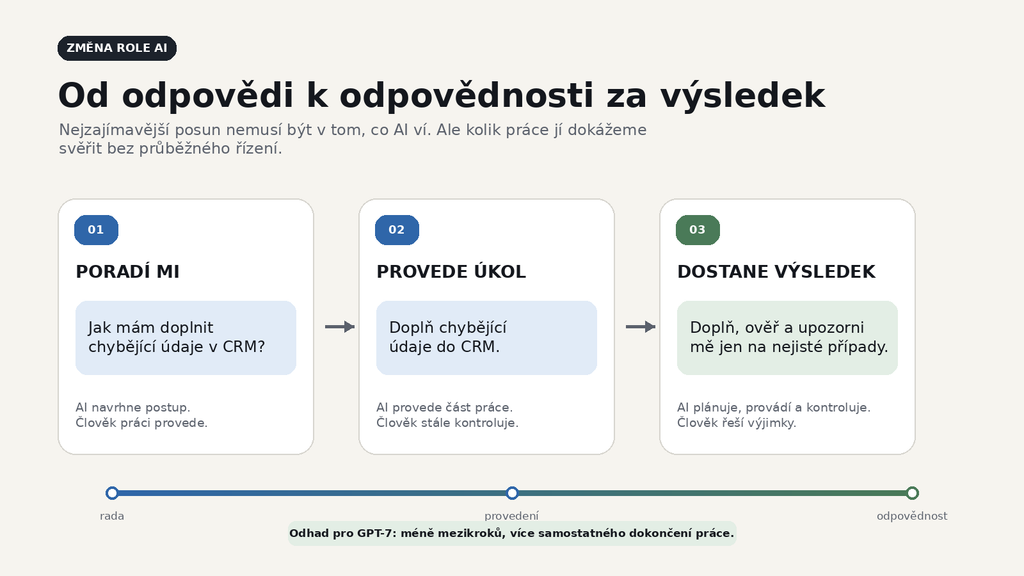
GPT se postupně mění z rádce na nástroj, který skutečně pracuje
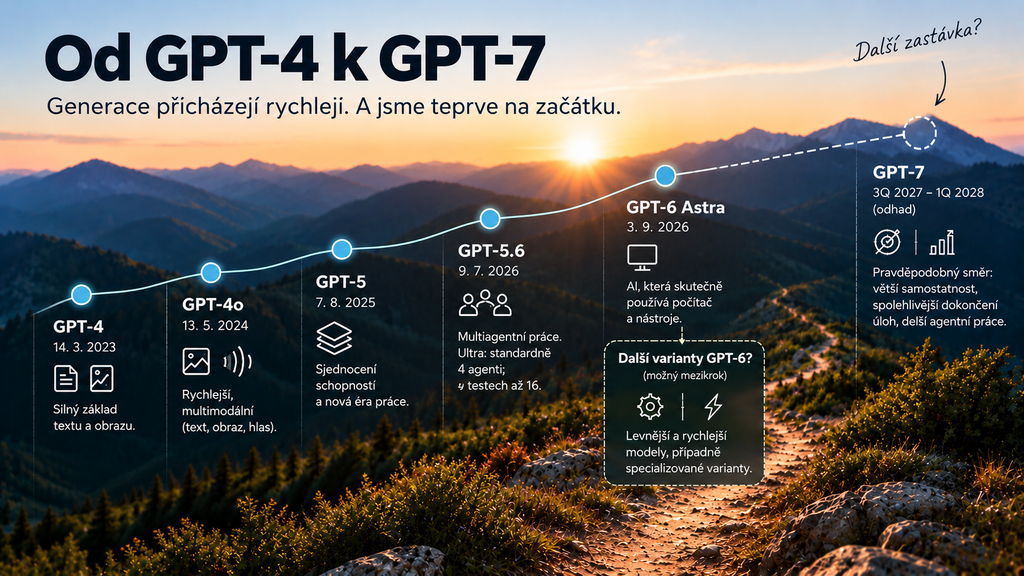
GPT-4 představilo OpenAI v březnu 2023. Velký dojem tehdy dělala schopnost pracovat nejen s textem, ale také s obrazem. Květen roku 2024 přinesl GPT-4o, které přidalo rychlejší a přirozenější komunikaci včetně hlasu.
GPT-5 z roku 2025 už začalo spojovat dříve oddělené směry: klasické jazykové modely, modely zaměřené na hlubší uvažování a používání nástrojů. Vidím tam zavedení systému, který odpovídá na většinu otázek, přidává hlubší uvažování pro složitější problémy a v reálném čase rychle rozhoduje, který model použít podle složitosti, potřeb nástrojů a záměru.
U GPT-5.6 z července 2026 se výrazněji objevuje také práce více AI agentů. OpenAI u režimu Ultra ve výchozím nastavení používá standardně čtyři agenty pracující paralelně a u některých experimentů zveřejnilo i výsledky se šestnácti agenty.
Agent nemusí být pro běžného uživatele žádná složitá technická věc. Můžeme si ho představit jako samostatného AI pracovníka, kterému systém přidělí jednu část problému. Jeden může procházet konkurenci, druhý analyzovat ceny a třetí kontrolovat závěry. Uživatel přitom klidně pořád komunikuje pouze s jedním ChatGPT.
GPT-6 Astra posouvá tento vývoj ještě více směrem k praktické práci. OpenAI mezi příklady uvádí aktualizaci CRM, vyplňování formulářů, organizaci kalendáře, práci s dokumenty, internetový průzkum, vytváření webových stránek nebo následné testování výsledku.
Rozdíl bych ukázal na jednoduchém příkladu. Máte v CRM padesát nových firem a u části chybí web, obor nebo další údaje. AI vám může informace pouze najít a předat je člověku. Další úroveň je, že je sama doplní do CRM. A ještě o kus dál se dostaneme ve chvíli, kdy informace sama najde, ověří, doplní a člověku ukáže jen ty případy, kde si není jistá. Právě poslední varianta je podle mě směr, kterým se nyní vývoj ubírá.
Největší posun Astry vidíme v praktické práci
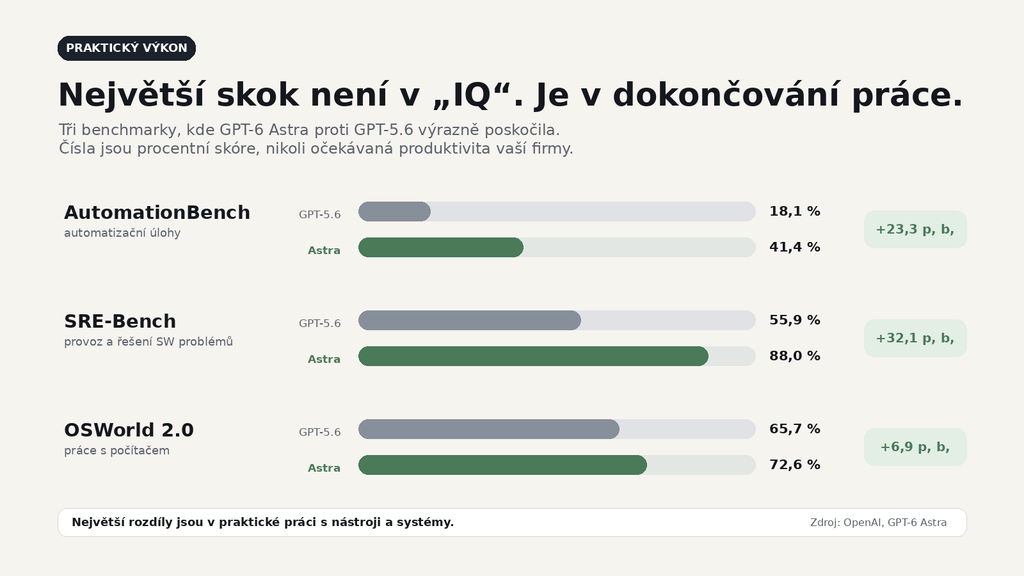
Dobře je to vidět na některých testech:
- v AutomationBench, který testuje schopnost AI zvládat reálnější pracovní a automatizační úlohy, vyskočilo skóre z 18,1 % u GPT-5.6 Sol na 41,4 % u GPT-6 Astra. Žebříček současně ukazuje skóre pro různé typy úloh, u těch marketingových je Astra aktuálně na 50 %, druhé místo obsadil Gemini 3.8 Flash (High) se 43 %.
- na SRE-Bench, který testuje schopnost modelu zpětně analyzovat software a pochopit jeho fungování bez přístupu ke zdrojovému kódu, narostl výsledek z 55,9 % na 88 %.
- u OSWorld 2.0, který testuje ovládání počítače, je posun ve skóre menší: z 65,7 % na 72,6 %. Zajímavější je rychlost. V simulaci latence na tomto benchmarku zvládla Astra úkol v průměru přibližně za 40 minut, zatímco GPT-5.6 Sol potřeboval zhruba 75 minut.
Samozřejmě to neznamená, že Astra bude ve firmě automaticky dvakrát produktivnější. Ukazuje to ale něco jiného. Největší posun nevidíme nutně tam, kde se měří obecné znalosti, ale tam, kde má AI něco skutečně udělat.
Zajímavé je srovnání v Artificial Analysis Intelligence Indexu v4.1.1, který skládá výsledky z několika různých benchmarků schopností modelu. V tabulce zveřejněné OpenAI má Astra 61,2 bodu a GPT-5.6 Sol 60,9 bodu. Rozdíl je tedy jen 0,3 bodu. Astra podle tohoto souhrnného indexu nepředstavuje dramatický skok v „obecné inteligenci“, přestože v některých konkrétních agentních a automatizačních úlohách jsou rozdíly výrazné.
Podle mě se tím dobře ukazuje, že další vývoj nebude jen o vyšším „IQ“ modelu. Stejně důležité bude, jak spolehlivě dokáže svoje schopnosti využít při skutečné práci.
Můžete mít mimořádně chytrého člověka, kterému musíte každý úkol rozdělit na pět kroků, třikrát ho zkontrolovat a dvakrát vrátit opravu. Pro firmu může mít větší hodnotu někdo, kdo není výrazně chytřejší, ale stačí mu vysvětlit cíl a přinese použitelný výsledek. Tady vidím jeden z hlavních prostorů pro GPT-7.
GPT-7 může fungovat samostatněji
U dnešních modelů je možné zadat poměrně složitou práci, ale u důležitých úkolů je stále potřeba výsledek kontrolovat. AI může přehlédnout část zadání, špatně ověřit zdroj nebo se příliš rychle spokojit s první variantou. Sám mám takové zkušenosti opakovaně.
Pokud bude pokračovat směr, který ukazuje Astra, mělo by postupně stačit lépe popsat cíl, pravidla a očekávaný výsledek. Například místo postupného zadávání průzkumu konkurence, dohledávání cen, kontroly zdrojů a zpracování závěru by AI měla zvládnout větší část tohoto postupu sama.
Část toho umí už současné modely. Rozhodující podle mě bude spolehlivost vybraného AI modelu. Právě to hraje při použití ve firmách významnou roli. V řadě firemních činností není nejdražší vytvořit první návrh. Čas zabere hlavně kontrola, opravy a další testování.
Programátor vytvoří kód, ale někdo ho musí spustit a ověřit. Marketér připraví analýzu, ale někdo musí projít zdroje a závěry. U tabulek je potřeba kontrolovat výsledný výstup, u webu funkčnost a u grafiky dodržení zadání.
Astra se snaží výrazněji pracovat právě tímto způsobem. OpenAI popisuje například schopnost vytvořit web a následně otestovat funkčnost nebo instalovat a testovat software. Na interním benchmarku halucinací také uvádí pokles z 16,3 % u GPT-5.6 na 5 % u Astry. Zde je fér dodat, že jde o test OpenAI, nikoli o nezávislý benchmark.
Od GPT-7 proto neočekávám pouze kvalitnější první výstup. Za důležitější považuji, aby si ChatGPT uměl výsledek sám otestovat, najít problém, opravit ho a znovu zkontrolovat. Pokud se sníží množství lidské kontroly, může to mít pro firmy větší ekonomický dopad než další zlepšení samotného generování textu nebo obrázků.
Někteří vývojáři už dnes stavějí nad současnými jazykovými modely vlastní nadstavby, které řeší věci, jež běžný ChatGPT zatím nezvládá optimálně. Přidávají vlastní agenty, kontroly, testování, práci s nástroji nebo řízení kontextu. To ukazuje, že další pokrok nemusí přijít jen z chytřejšího modelu, ale také z lepšího systému kolem něj. Zároveň ale neplatí, že lepší model už není potřeba. Čím lépe model chápe zadání, plánuje, vybírá nástroje a vyhodnocuje vlastní chyby, tím účinnější může být i samotná nadstavba.
Jeden ChatGPT může pracovat jako několik lidí
Dalším pravděpodobným směrem je podle mě větší využití více agentů. Uživatel nemusí nic speciálního nastavovat. Zadá například analýzu vstupu na slovenský trh a systém si sám rozdělí práci. Jeden agent může procházet konkurenci, další cenovou hladinu, jiný zákaznické zkušenosti a další legislativní požadavky. Výsledky následně může zkontrolovat další model.
Neříkám, že bude deset agentů řešit každou jednoduchou otázku. To by bylo zbytečně drahé. U komplexnější práce ale spuštění souběžného řešení dává smysl a OpenAI tento princip používá už dnes. U GPT-7 bych proto očekával především lepší rozhodování o tom, kdy má význam práci rozdělit a jak následně výsledky jednotlivých agentů zkontrolovat a spojit.
Kontextové okno není potřeba nafukovat donekonečna
Při debatách o nových modelech se často řeší také velikost kontextového okna. Kontextové okno můžeme zjednodušeně chápat jako pracovní stůl AI. Obsahuje aktuální zadání, dokumenty, předchozí komunikaci a další informace, které má model při práci právě před sebou.
Jeho velikost se počítá v tokenech. Token je zjednodušeně malá část textu. Pro běžného uživatele není potřeba řešit přesný přepočet na slova. Zajímavé je, že GPT-5.6 Sol i GPT-6 Astra mají stejné kontextové okno: 1 050 000 tokenů. Přesto Astra pracuje s dlouhým kontextem lépe. OpenAI například na testu MRCR v rozsahu 512 tisíc až 1 milion tokenů uvádí zlepšení z 73,8 % u GPT-5.6 na 96,3 % u Astry.
Proto si nemyslím, že dalším nutným krokem musí být kontext desetkrát větší. Pro praxi je podstatnější, zda AI dokáže v informacích najít to, co opravdu potřebuje. Pokud na projektu pracuje několik dní, měla by vědět, proč jsme určitou možnost už odmítli, jaké rozhodnutí padlo před dvěma dny a kde se nachází správná verze dokumentu.
Milion tokenů, ve kterých AI špatně hledá, má menší hodnotu než menší množství dobře organizovaných informací.
AI se bude dostávat hlouběji do firemních systémů
Další posun podle mě nastane v tom, kde AI samotnou používáme. Dnes se často ptáme, jak něco udělat v CRM, účetnictví nebo reklamním systému. AI připraví návod a člověk změnu provede. S agentními systémy se rozdíl postupně stírá. AI může mít oprávnění potřebnou změnu sama udělat. Tím ale vzniká nový problém, který podle mě firmy zatím trochu podceňují: oprávnění a kontrola.
Pokud zaměstnanec pracuje v účetnictví, také mu automaticky nedáváme neomezený přístup ke všemu. Podobně by měla fungovat AI. Může připravit fakturu, ale nemusí mít oprávnění ji odeslat. Může navrhnout reklamní kampaň, ale neměla by bez omezení utratit statisíce korun. Může připravit změnu ceny, ale finální publikaci může stále potvrzovat člověk.
Čím více bude AI skutečně dělat, tím méně bude bezpečnost stát pouze na tom, zda nám napsala správnou odpověď. Bude potřeba řešit také to, co smí změnit, kdo změnu schvaluje a zda lze zpětně dohledat, co se stalo.
Kdy může GPT-7 přijít?
Tady už se dostáváme k čistému odhadu.
GPT-4 přišlo 14. března 2023. GPT-4o následovalo 13. května 2024, GPT-5 7. srpna 2025 a GPT-6 Astra 3. září 2026.
Mezi GPT-4 a GPT-5 tedy uplynulo přibližně 29 měsíců. Pokud jako velký mezikrok vezmeme GPT-4o, mezi GPT-4o a GPT-5 je zhruba 15 měsíců. Mezi GPT-5 a GPT-6 Astra už jen 392 dní, tedy necelých 13 měsíců.
Kdybych poslední interval jednoduše zopakoval, vycházelo by další velké vydání přibližně na konec září 2027.
Tak přesný bych ale určitě nebyl. Máme příliš málo generačních přechodů, abychom z nich mohli vytvořit spolehlivou matematickou řadu. Navíc je vidět, že další vývoj začínají více ovlivňovat bezpečnostní otázky. Nelze předpokládat, že se generační cyklus bude neustále zkracovat.
Navíc lze čekat, že tempo dalších vydání budou stále více ovlivňovat i bezpečnostní otázky a nutnost nové modely důkladněji testovat. Nelze proto předpokládat, že se generační cyklus bude automaticky dál zkracovat.
Můj současný odhad je GPT-7 někdy mezi 3. čtvrtletím 2027 a 1. čtvrtletím 2028, nejspíše ke konci roku 2027. Je to odhad podle současného vývoje, nikoli informace OpenAI.
Co to bude znamenat pro firmy
Debata o AI se často zjednodušuje na otázku, která pracovní místa zaniknou. Podle mě je zajímavější dívat se na jednotlivé činnosti.
Obchodník nehledá jen nové zákazníky. Také zapisuje informace do CRM, připravuje nabídky, plánuje schůzky, píše e-maily a kontroluje, kdo se neozval. Marketér analyzuje data, sleduje konkurenci, připravuje zadání, kontroluje kampaně, píše texty a sestavuje reporty. Podobně bychom mohli rozebrat účetního, personalistu nebo pracovníka zákaznické podpory.
AI nemusí jednu profesi najednou kompletně nahradit. Může postupně přebírat jednotlivé činnosti, nejdříve ty nejjednodušší a nejlépe popsatelné. Proto bych při plánování firmy méně řešil otázku „nahradí AI tuto pozici?“ a více se díval na to, co konkrétně lidé během dne dělají a kolik z těchto činností lze postupně automatizovat.
Poslední roky jsme se hodně učili, jak správně psát prompty. Jak definovat roli, rozepsat jednotlivé kroky nebo model donutit ke kontrole. To má stále význam, ale nemyslím si, že v roce 2028 bude hlavní konkurenční výhodou firmy zaměstnanec, který umí napsat dvoustránkový prompt.
Čím budou modely schopnější, tím lépe si postup pravděpodobně vytvoří samy. Firma ale stále musí dodat správné podklady. AI musí vědět, kde jsou aktuální data, jaká pravidla platí, kdo co schvaluje a podle čeho má poznat správný výsledek.
Pokud máte deset různých verzí ceníku, důležité postupy pouze v hlavách zaměstnanců a nikdo přesně neví, která informace je aktuální, samotná nová verze ChatGPT tento problém nevyřeší. Spíše ho zdědí.
Co bych řešil už dnes
Kvůli GPT-7 bych určitě nepřestavoval celou firmu. Nevíme, kdy přesně přijde ani jak bude vypadat. Současně bych ale nečekal. Začal bych tím, že si ve firmě najdu opakující se činnosti, které dnes lidé stále dokola dělají ručně. Přepisování údajů mezi systémy, přípravu podobných reportů, dohledávání stejných informací nebo opakovanou kontrolu standardních věcí.
Druhou oblastí jsou firemní informace. Pokud má AI v budoucnu dělat větší část práce samostatně, potřebuje pracovat se správnými daty. Má proto smysl už dnes vědět, kde se nachází vaše znalostní báze a zda vůbec poznáte, která verze dokumentu je aktuální.
A třetí oblastí jsou oprávnění. Jakmile AI začne skutečně pracovat v CRM, účetnictví, e-mailu nebo reklamních účtech, je potřeba určit, co smí pouze přečíst, co může připravit a kterou změnu už musí potvrdit člověk. To jsou podle mě mnohem praktičtější přípravy na další generaci AI než studování stovek promptovacích triků.
Na GPT-7 bych nečekal
Z článku by mohl vzniknout dojem, že teď stačí rok počkat a všechno začne fungovat samo. Tak bych to určitě nebral. Řada schopností, které očekávám od GPT-7, už nějakým způsobem existuje. AI používá počítač, pracuje s více agenty, ovládá nástroje a začíná si výsledek sama kontrolovat.
Největším rozdílem další generace proto nemusí být úplně nová schopnost. Může jím být především její spolehlivost. Automatizace, která funguje správně v šesti případech z deseti, vám může přidělat více práce než užitku. Pokud se dostane například na 95 nebo 99 %, už kvůli ní může dávat smysl změnit celý firemní proces.
A právě to bych u GPT-7 sledoval nejvíce. Ne jestli získá ještě vyšší číslo v nějakém testu, ale zda mu budeme moci svěřit větší kus práce bez toho, abychom mu celou dobu stáli za zády. Možná proto GPT-7 nebude na první pohled působit tak revolučně. Na běžnou otázku může odpovědět jen o něco lépe než dnešní Astra. Rozdíl se může projevit jinak. Dnes AI často říkáme, jak má něco udělat. Postupně jí budeme častěji říkat, čeho potřebujeme dosáhnout.
Pokud si dokáže sama dohledat podklady, vybrat nástroje, rozdělit práci, zkontrolovat výsledek a přijít za člověkem jen ve chvíli, kdy je opravdu potřeba rozhodnout, může to být pro firmy podstatnější změna než další skok v samotné inteligenci modelu. Proto bych se dnes méně ptal, jak chytré bude GPT-7. Důležitější bude, jak schopný bude celý systém, do kterého jej OpenAI zasadí. Model, nástroje, paměť, subagenti, kontroly a přístupy do dalších aplikací se totiž postupně stávají jedním produktem, přestože technicky jde o různé vrstvy.
GPT-7 nemusí přinést magicky nový seznam schopností. Revoluce může být v tom, že kombinace lepšího modelu a lepšího harnessu začne dělat spolehlivě to, co dnes už technicky umíme, ale zatím ne dost konzistentně.
Ve veřejných debatách zatím nejsou věrohodné informace o konkrétních parametrech GPT-7. Směr vývoje je ale poměrně dobře vidět. Místo dalšího chatbotu lze čekat spíše osobního agenta, který zvládne delší úkoly, bude pracovat napříč aplikacemi a dokáže část práce plánovat, provést a zkontrolovat bez průběžného vedení člověkem. Dalším krokem může být větší využití týmů AI agentů a také AI při vývoji dalších modelů. Největší překážkou přitom nemusí být samotná inteligence, ale otázka, kolik autonomie lze takovým systémům bezpečně dát.
